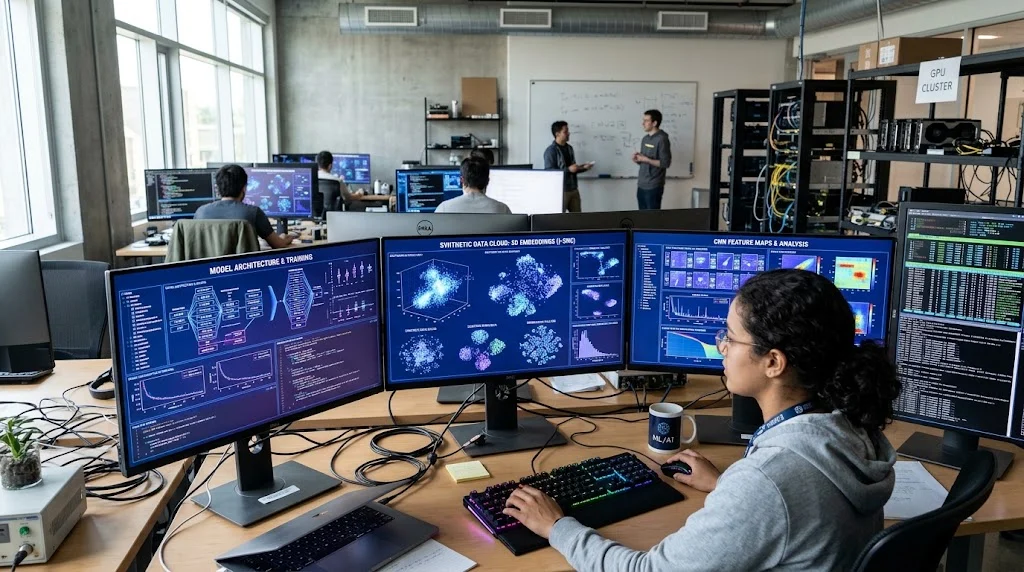
Представьте себе архитектора, который строит город будущего, но в его распоряжении есть только чертежи старых деревянных домов. Чтобы научить автопилот ориентироваться в нештатных ситуациях или распознавать редкие дорожные знаки, инженерам больше не нужно годами ждать реальных дорожных происшествий. На помощь приходит генерация синтетических данных — искусственно созданных датасетов, которые воспроизводят статистические свойства и закономерности реального мира.
Проблема дефицита и качество информации
Современные большие языковые модели и нейросети компьютерного зрения требуют для обучения колоссальных объемов информации. Однако качественные, вручную размеченные реальные данные становятся дефицитным и дорогим ресурсом. Медицинские снимки редких патологий, редкие финансовые транзакции или экстремальные сценарии для робототехники физически невозможно собрать в нужных объемах без колоссальных затрат времени и риска для безопасности.
Здесь синтетические данные действуют подобно тренажеру-симулятору для пилотов гражданской авиации. Пилот учится справляться с отказами двигателей и ураганным ветром в виртуальной кабине, где ошибка ничего не стоит. Точно так же алгоритмы машинного обучения тренируются на виртуальных симуляциях физических процессов или на текстах, сгенерированных более мощными языковыми моделями.
Методы генерации и баланс реалистичности
Создание качественных синтетических данных опирается на несколько ключевых подходов. Первый — использование генеративных моделей, таких как диффузионные сети или вариационные автоэнкодеры, которые создают новые визуальные или текстовые образцы на основе имеющегося распределения. Второй подход применяется в физике и робототехнике: это симуляторы на базе движков реального времени, воссоздающие законы гравитации, освещения и трения.
Главный вызов при этом — избежать так называемого коллапса модели и накопления ошибок. Если нейросеть обучается исключительно на данных, порожденных другими нейросетями без достаточного контроля разнообразия, со временем качество ее генерации деградирует. Модель начинает воспроизводить собственные артефакты, теряя связь с реальной физикой или логикой языка.
Конфиденциальность и этика
Помимо решения проблемы дефицита, синтетические данные открывают путь к обложению строгих регуляторных барьеров, связанных с персональными данными. В таких сферах, как медицина или банковское дело, обучать модели на реальных записях клиентов мешают законы о защите приватности (например, GDPR). Создание синтетических аналогов, сохраняющих математические корреляции исходных баз данных, но не содержащих реальных имен и историй людей, позволяет проводить глубокую аналитику и обучать ИИ-агентов без угрозы утечки конфиденциальной информации.
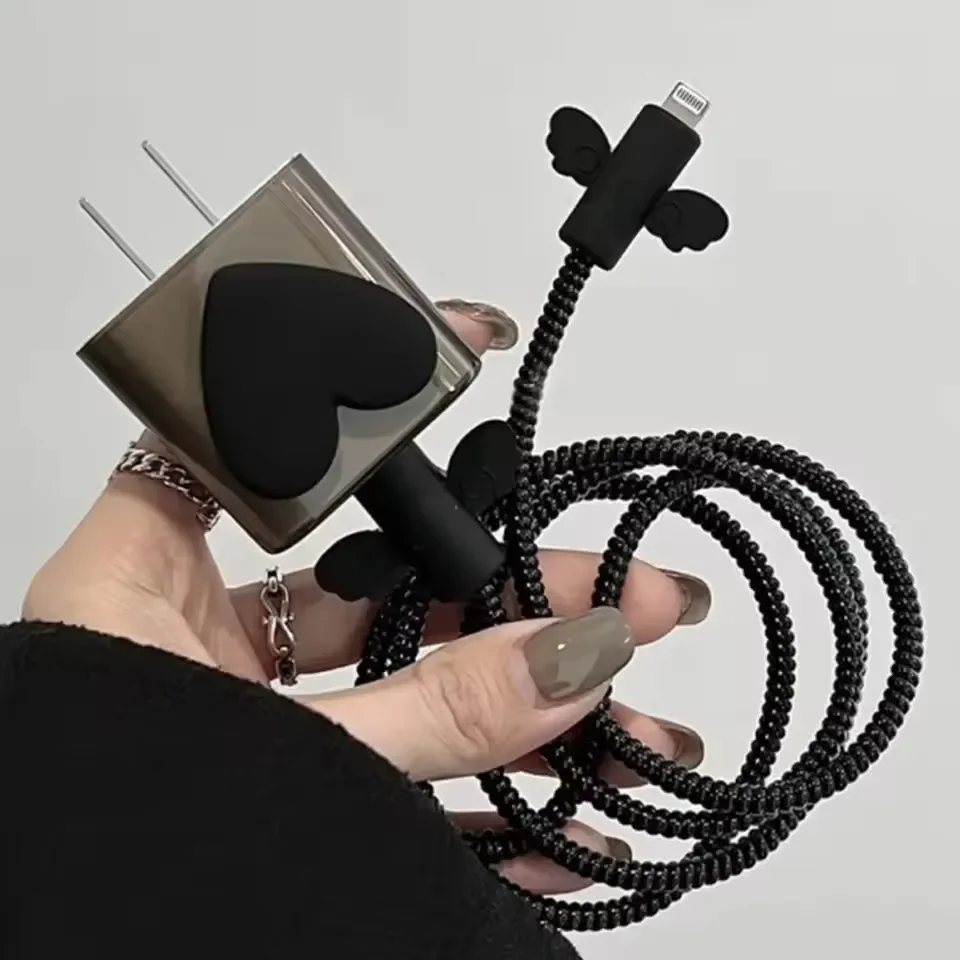 Черный набор из 5 шт. с бантиком: защитные аксессуары для кабеля зарядки и передачи данных, органайзер для зарядного устройства iPhone 18/20W, защитный чехол.
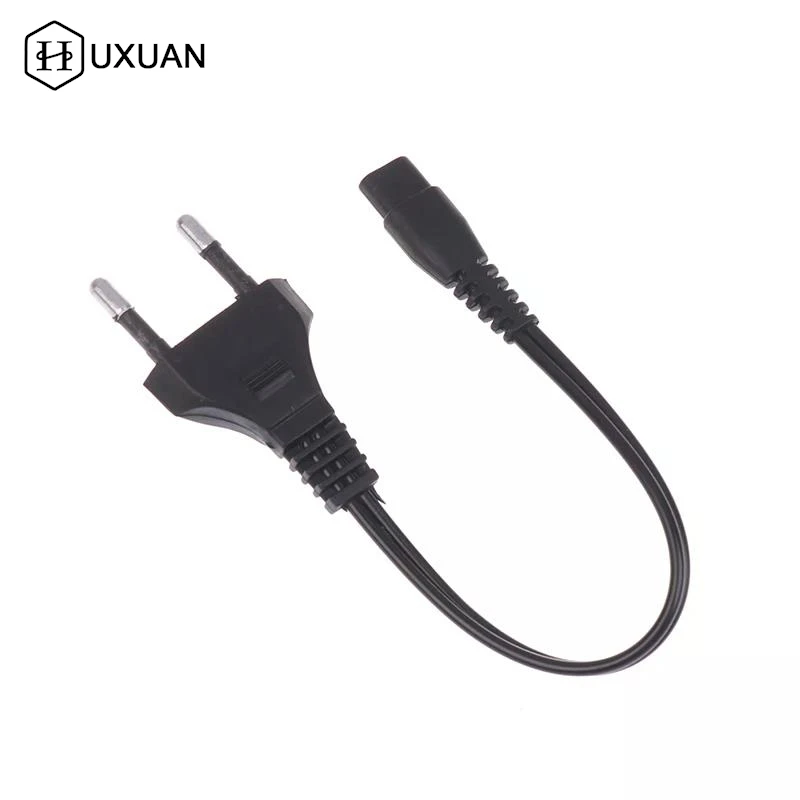 Зарядный кабель с двойным отверстием, вилка европейского стандарта, 220 В, 110 В, прямая зарядка, фонарик, зарядное устройство, шнур питания, аксессуары для фонарика
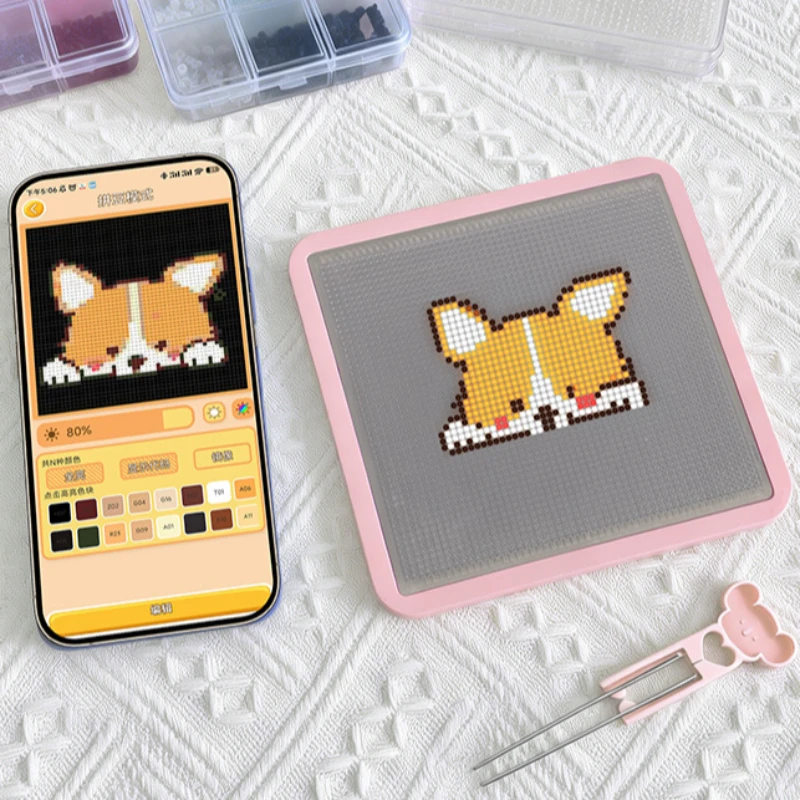 Набор для творчества с умными светодиодными плавящимися бусинами на подставке, электронные плавящиеся бусины, принадлежности для рукоделия, домашний декор ручной работы, креативный подарок на день рождения.
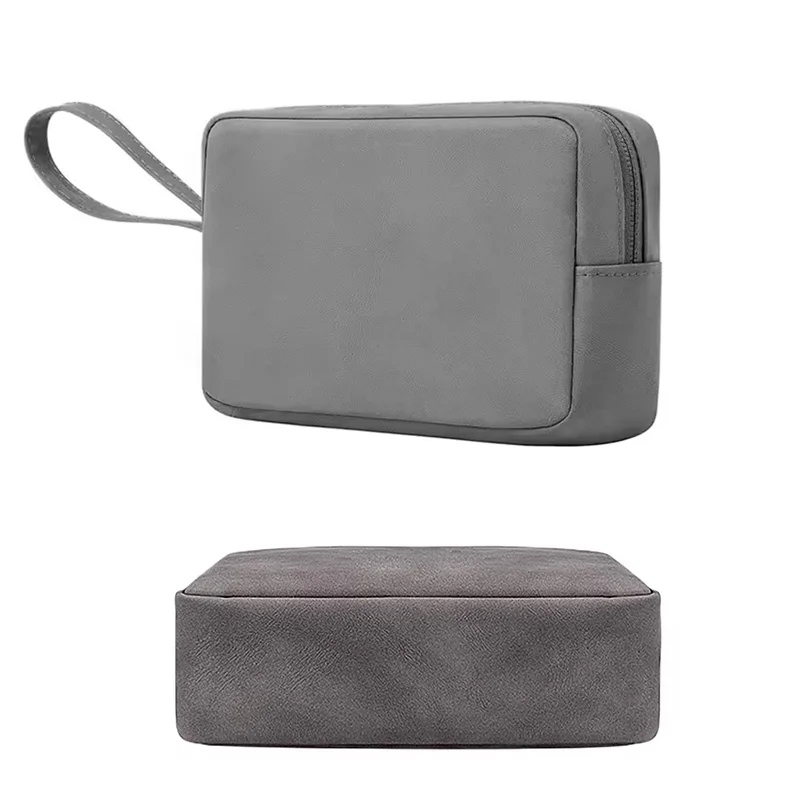 Портативная сумка для зарядных кабелей, органайзер для мелкой электроники и цифровых устройств для iPhone 16, наушников, внешнего аккумулятора, USB-кабелей и аксессуаров для зарядки.
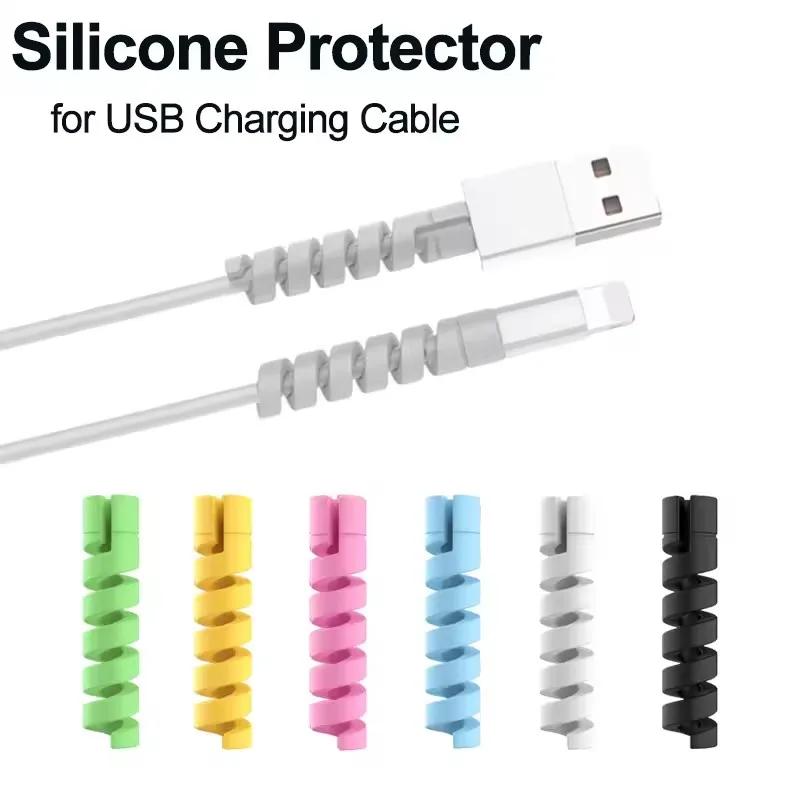 6/20 шт. силиконовых защитных чехлов для кабелей, спиральные намотчики для зарядных кабелей, защитные накладки для концов проводов, аксессуары для USB-кабелей зарядных устройств для телефонов.
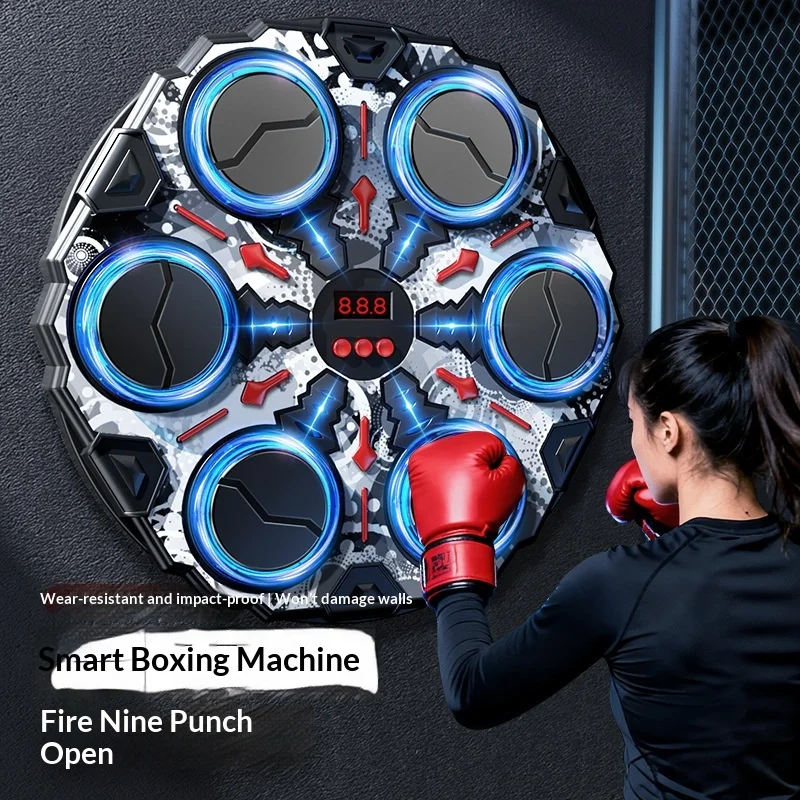 Умная музыкальная боксерская машина, настенная электронная боксерская мишень с регулируемой скоростью, тренажер для развития реакции, предназначенный для использования в помещении.