Когда базовая языковая модель или мультимодальная нейросеть развернута, перед инженерами встает задача адаптации под специфические бизнес-задачи или доменные области. Простой промптинг помогает далеко не всегда, особенно когда требуется глубокое понимание специфической терминологии, строгий формат ответов или специфическая логика принятия решений. Здесь начинается этап дообучения, где ключевым развилкой становится выбор между Full Fine-Tuning (полным дообучением) и методом Parameter-Efficient Fine-Tuning, в частности его самым популярным представителем — LoRA (Low-Rank Adaptation).
Понимание разницы между этими подходами выходит далеко за рамки простой экономии видеопамяти. Это архитектурный компромисс, затрагивающий скорость обучения, деградацию базовых навыков модели, требования к инфраструктуре и дальнейшую сложность развертывания инференса. Разбор технических особенностей каждого метода позволяет точно определить, какой подход применим для конкретной задачи.
Полное дообучение (Full Fine-Tuning): архитектурные особенности и цена точности
При полном дообучении изменениям подвергаются абсолютно все веса базовой модели. Если перед нами модель размером в 7 миллиардов параметров, то в процессе обратного распространения ошибки градиенты вычисляются и обновляются для каждого тензора внимания, слоев MLP и нормализации.
Главный плюс такого подхода заключается в максимальной свободе изменения пространства признаков. Модель не просто заучивает новые паттерны, она способна существенно перестроить внутренние репрезентации, если доменные данные кардинально отличаются от исходного датасета претрейна. Качество адаптации под узкоспециализированные задачи при достаточном объеме качественных данных здесь максимальное.
Однако обратная сторона технически тяжела. Объем видеопамяти (VRAM) во время обучения определяется не только размером самой модели, но и весами оптимизатора (например, AdamW хранит моменты первого и второго порядка), градиентами и активациями. Для модели на 7B параметров в режиме FP16 требуется около 14 ГБ под веса, но для полного обучения с AdamW объем VRAM мгновенно возрастает до 80 ГБ и более, требуя кластеров из нескольких GPU или сложных техник шардинга (DeepSpeed ZeRO-3).
LoRA (Low-Rank Adaptation): математика низкоранговых аппроксимаций
Метод LoRA исходит из наблюдения исследователей: веса нейросетей в процессе адаптации к конкретным задачам обладают так называемой «внутренней размерностью» (intrinsic dimension), которая значительно ниже общего числа параметров.
Вместо того чтобы модифицировать исходную матрицу весов W (замораживая ее), LoRA добавляет параллельные обучаемые ветви — матрицы разложения малого ранга r. Если исходная весовая матрица имеет размер d x k, то вместо обновления W на величину dW, мы аппроксимируем dW произведением двух матриц меньшего ранга: A (размером r x k) и B (размером d x r), где ранг r обычно выбирается очень маленьким (например, 8, 16 или 32).
Во время прямой и обратной связи базовые веса W остаются неизменными (frozen), градиенты для них не считаются, а оптимизатор обновляет только параметры матриц A и B. Это снижает объем памяти под градиенты и состояния оптимизатора на порядок. Обучать модели среднего размера становится возможно на одной потребительской или серверной видеокарте.
Критерии выбора: производительность, качество и инфраструктура
Выбор между методами зависит от четырех ключевых параметров: доступного бюджета, специфики домена, требований к задержкам и объема обучающей выборки.
Объем датасета играет решающую роль. Если для обучения есть миллионы уникальных примеров сложной структуры, Full Fine-Tuning сможет полностью перестроить внутреннюю логику модели. Если же датасет насчитывает несколько тысяч или десятков тысяч примеров, полное дообучение быстро приводит к переобучению (overfitting), в то время как LoRA за счет ограничения емкости новых весов сохраняет устойчивость.
Инфраструктурные ограничения часто диктуют решение в пользу LoRA еще на этапе проектирования. Затраты на аренду кластеров GPU для полного цикла экспериментов с большими моделями несопоставимы с затратами на запуск LoRA-адаптеров. Кроме того, при развертывании в продакшене архитектура с LoRA позволяет хранить одну тяжелую базовую модель в памяти и подключать к ней легкие адаптеры под разных клиентов или задачи «на лету» без перезагрузки всей модели.
Скрытые компромиссы и подводные камни
Несмотря на популярность LoRA, метод имеет ограничения. Иногда низкорангового приближения оказывается недостаточно для задач, требующих кардинального изменения синтаксиса или добавления принципиально новых языков программирования или естественных языков, отсутствовавших в базовом претрейне.
Еще один нюанс — слияние весов (merging). После окончания обучения матрицу адаптера можно математически сложить с базовыми весами (W + B*A), чтобы во время инференса не было накладных расходов на дополнительные матричные умножения. Однако при небрежном подборе коэффициентов скалярного умножения (альфа-параметр LoRA) это слияние иногда приводит к незначительной деградации метрик, требующей валидации.
Кому какой путь подходит
Полное дообучение оправдано, когда создается базовая модель организации с нуля на основе открытых архитектур, когда бюджет позволяет содержать массивные кластеры вычислений и когда требуется максимальная глубина адаптации под принципиально новый домен знаний.
LoRA становится стандартом де-факто для большинства продуктовых команд, которым нужно быстро, эффективно и с минимальными затратами адаптировать существующие мощные открытые языковые или мультимодальные модели под конкретные бизнес-процессы, сохранив при этом универсальность базовой модели.
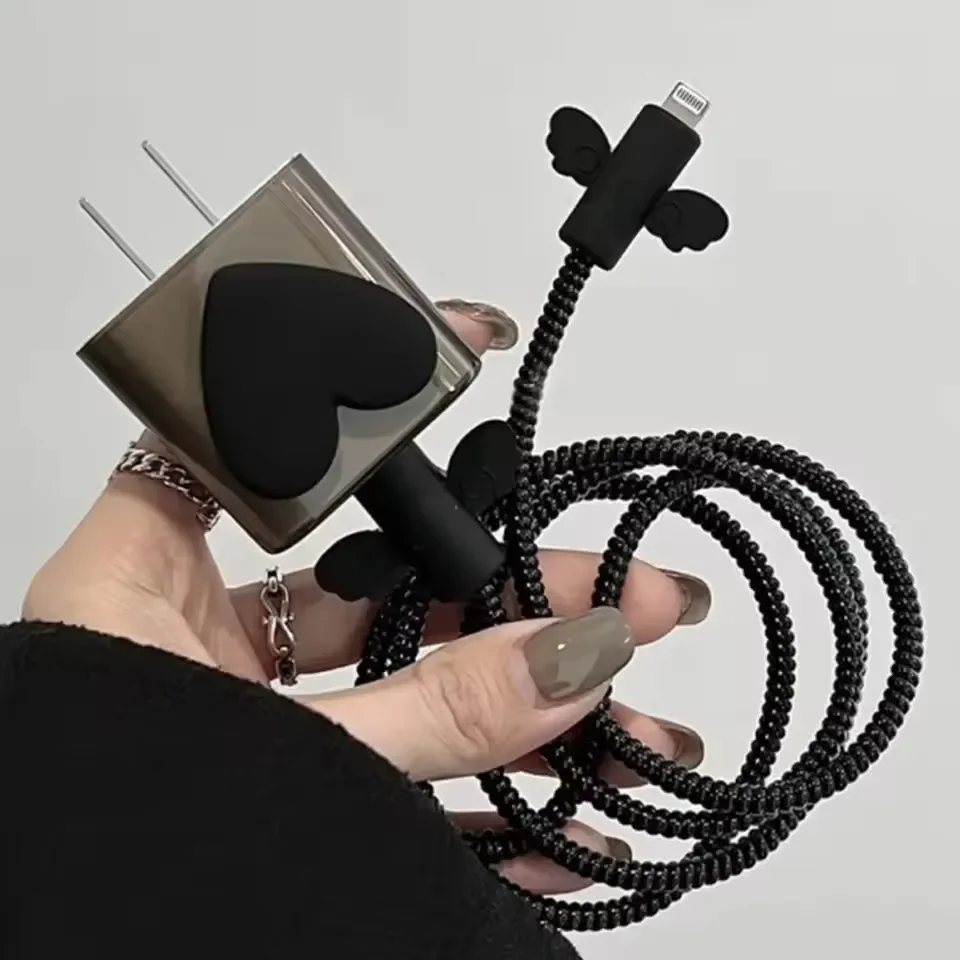 Черный набор из 5 шт. с бантиком: защитные аксессуары для кабеля зарядки и передачи данных, органайзер для зарядного устройства iPhone 18/20W, защитный чехол.
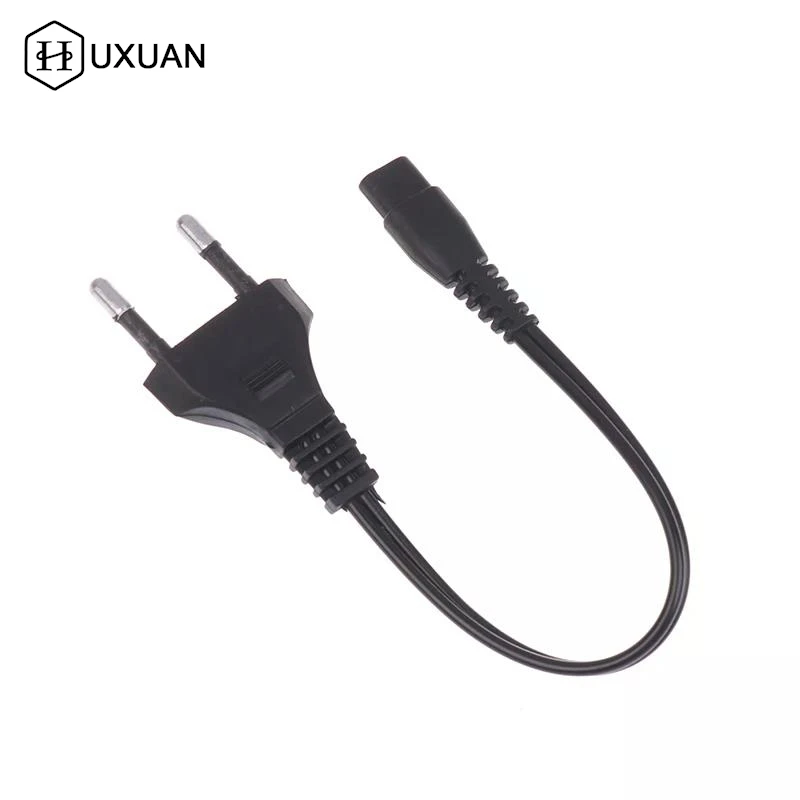 Зарядный кабель с двойным отверстием, вилка европейского стандарта, 220 В, 110 В, прямая зарядка, фонарик, зарядное устройство, шнур питания, аксессуары для фонарика
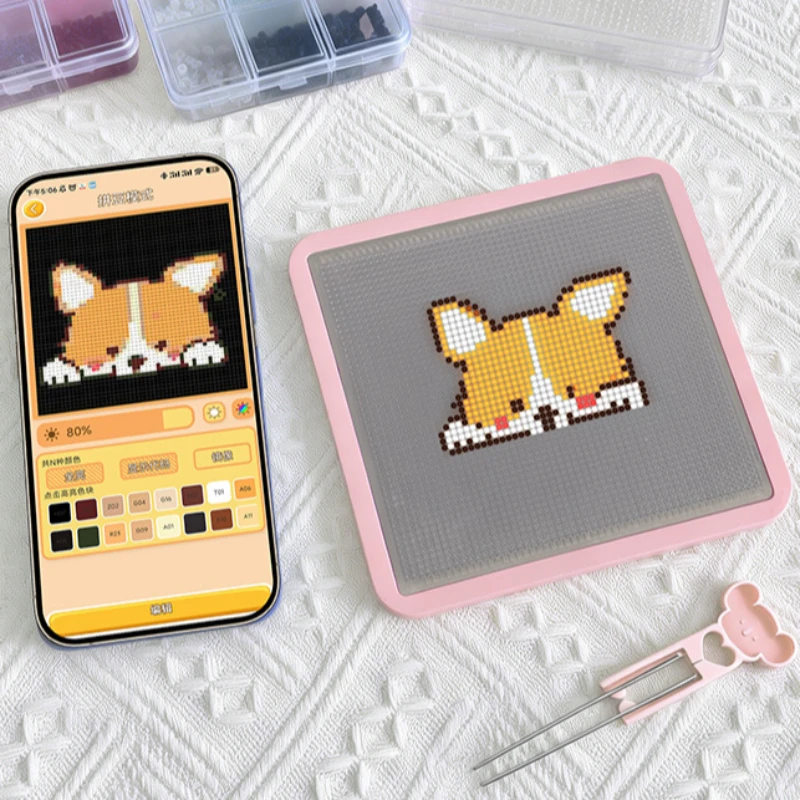 Набор для творчества с умными светодиодными плавящимися бусинами на подставке, электронные плавящиеся бусины, принадлежности для рукоделия, домашний декор ручной работы, креативный подарок на день рождения.
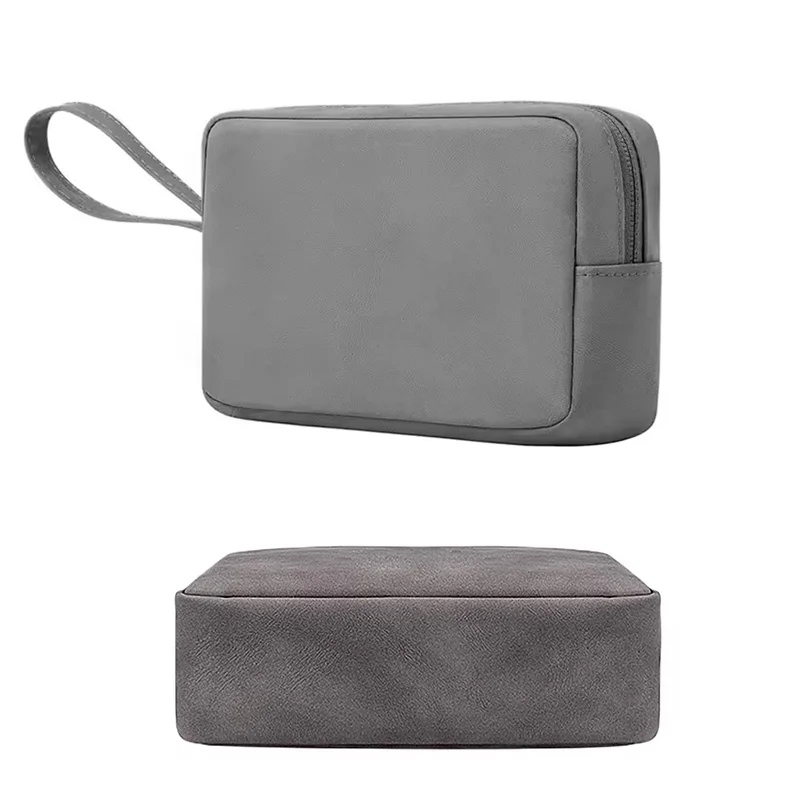 Портативная сумка для зарядных кабелей, органайзер для мелкой электроники и цифровых устройств для iPhone 16, наушников, внешнего аккумулятора, USB-кабелей и аксессуаров для зарядки.
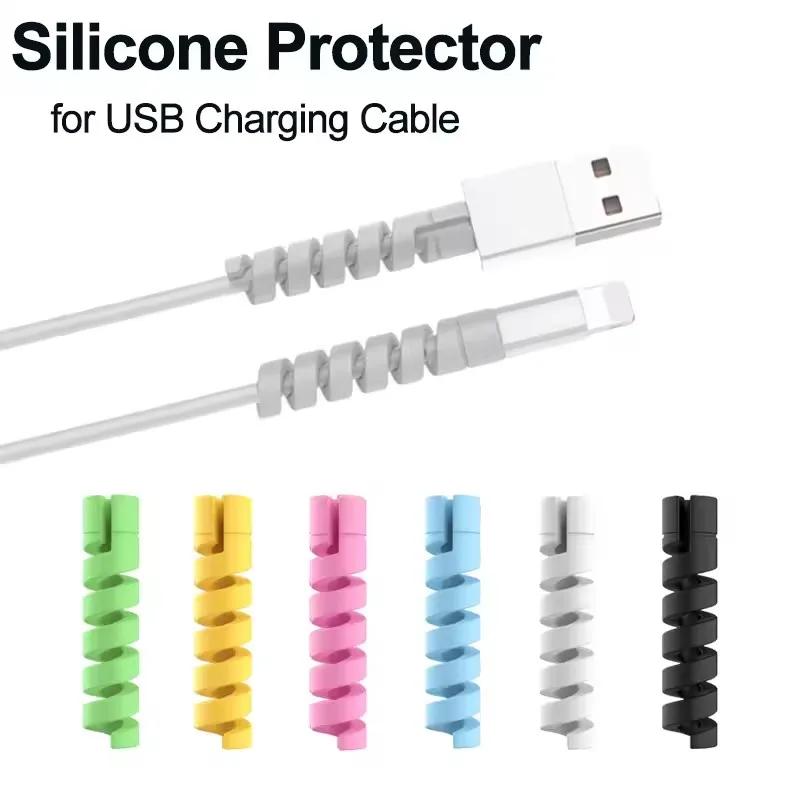 6/20 шт. силиконовых защитных чехлов для кабелей, спиральные намотчики для зарядных кабелей, защитные накладки для концов проводов, аксессуары для USB-кабелей зарядных устройств для телефонов.
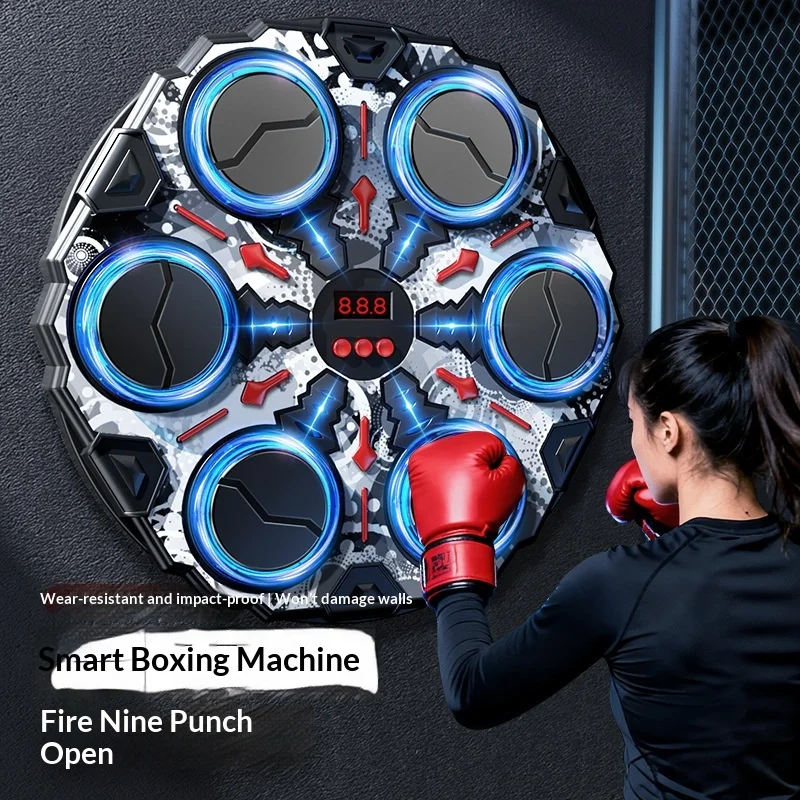 Умная музыкальная боксерская машина, настенная электронная боксерская мишень с регулируемой скоростью, тренажер для развития реакции, предназначенный для использования в помещении.