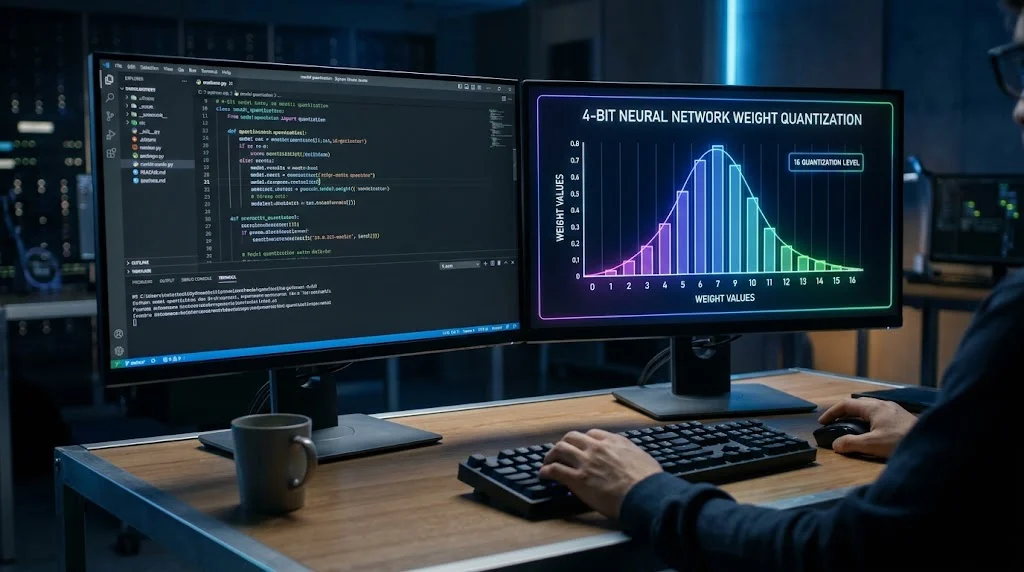
Запуск крупных языковых моделей (LLM) на потребительском «железе» или оптимизация серверных затрат упираются в одну главную проблему — колоссальный объем оперативной памяти, требуемый для хранения весов модели. Переход с 16-битной точности (FP16) на 4-битное квантование позволяет сократить размер модели в четыре раза при минимальной потере качества генерации. Разберем пошаговый алгоритм перевода весов и настройки локального инференса.
Подготовка окружения и выбор инструментария
Первый шаг перед началом квантования — выбор формата под ваши задачи. Для запуска на CPU и гибридных системах (с выгрузкой части слоев на GPU) стандартом де-факто стал формат GGUF, поддерживаемый экосистемой llama.cpp. Для чисто GPU-инференса с максимальной скоростью обработки токенов чаще применяются форматы AWQ (Activation-aware Weight Quantization) или GPTQ.
Установите необходимые библиотеки для работы с Python и конвертации весов:
- Создайте изолированное виртуальное окружение через venv или conda.
- Установите последнюю стабильную версию библиотеки transformers и вспомогательные пакеты для квантования (например, autoawq или llama-cpp-python).
- Убедитесь, что у вас установлена актуальная версия CUDA, если планируете задействовать графический ускоритель NVIDIA.
Процесс квантования весов
На этом этапе исходные веса модели из FP16 преобразуются в низкоразрядное представление. Основная задача алгоритма квантования — минимизировать отклонение выходных активаций сети за счет избирательного округления весов.
Скачайте исходную модель из репозитория Hugging Face на локальный диск. Запустите скрипт конвертации, указав целевую разрядность (например, Q4_K_M для GGUF, что означает сбалансированное 4-битное квантование с разной степенью сжатия для критических слоев). Следите за тем, чтобы процесс конвертации не прерывался из-за нехватки оперативной памяти на этапе загрузки исходной модели в память хоста.
Промежуточный результат и валидация
После завершения конвертации вы получаете единственный файл весов (в формате .gguf) или папку с оптимизированными слоями (для AWQ).
Частая ошибка на этом этапе — запуск модели без проверки перплексии (perplexity) или визуального качества генерации. Обязательно проведите тестовый прогон на небольшой выборке валидационных данных, чтобы убедиться, что модель не «деградировала» и корректно отвечает на базовые запросы.
Настройка параметров инференса и частые препятствия
Главная техническая сложность при работе с квантованными моделями — правильный подбор размера контекста (context window) и объема выделенной памяти под KV-кеш. При уменьшении весов до 4 бит относительная доля памяти под контекст возрастает.
Настройте параметры запуска через бэкенд (например, Ollama или llama-cpp): ограничьте число параллельных потоков (threads) равным количеству физических ядер процессора, избегайте гипертрединга для тяжелых вычислительных задач, и выделите под GPU ровно столько слоев, сколько помещается в видеопамять без риска уйти в оверфлоу (out-of-memory).
 Дорожная сумка для кабелей, портативный чехол для хранения цифровых устройств, органайзер для зарядных устройств и кабелей USB, водонепроницаемая сумка для хранения электронных аксессуаров.
 Умная колонка с голосовым помощником AI, Bluetooth, RGB-подсветкой, будильником, LED-экраном и отображением погоды
 Черный набор из 5 шт. с бантиком: защитные аксессуары для кабеля зарядки и передачи данных, органайзер для зарядного устройства iPhone 18/20W, защитный чехол.
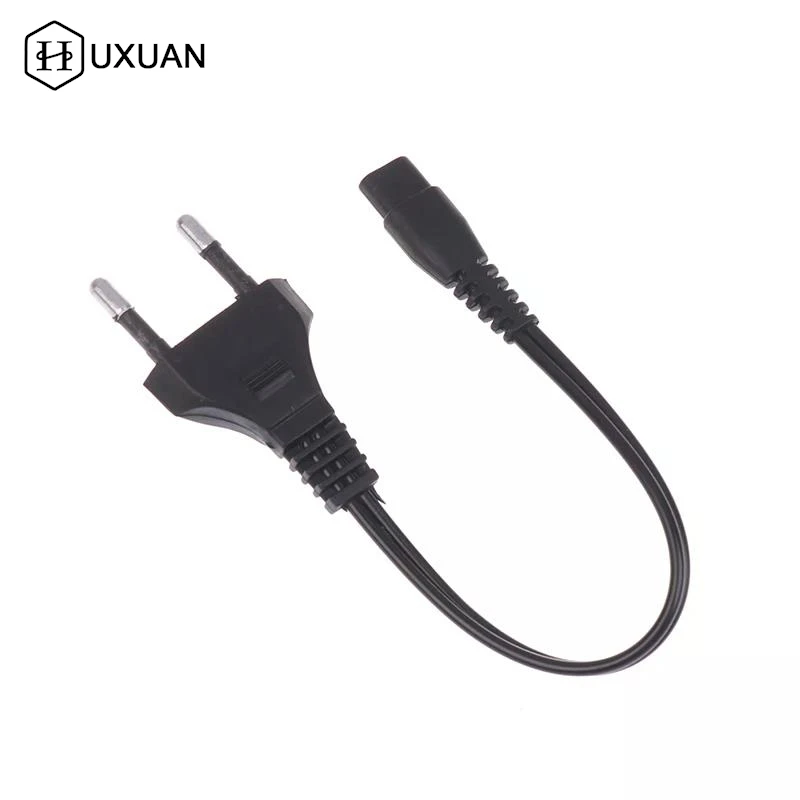 Зарядный кабель с двойным отверстием, вилка европейского стандарта, 220 В, 110 В, прямая зарядка, фонарик, зарядное устройство, шнур питания, аксессуары для фонарика
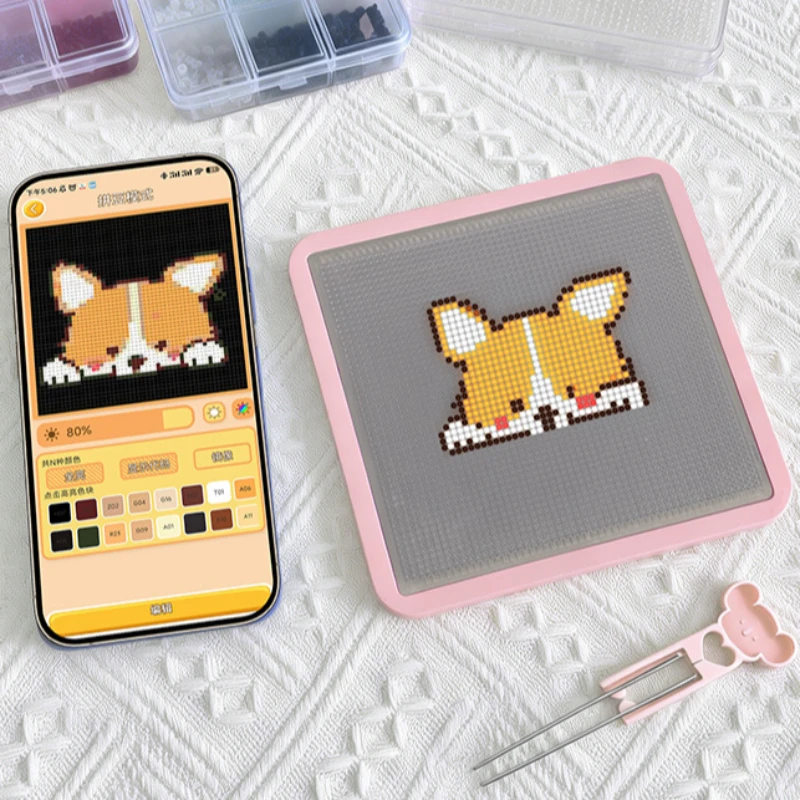 Набор для творчества с умными светодиодными плавящимися бусинами на подставке, электронные плавящиеся бусины, принадлежности для рукоделия, домашний декор ручной работы, креативный подарок на день рождения.
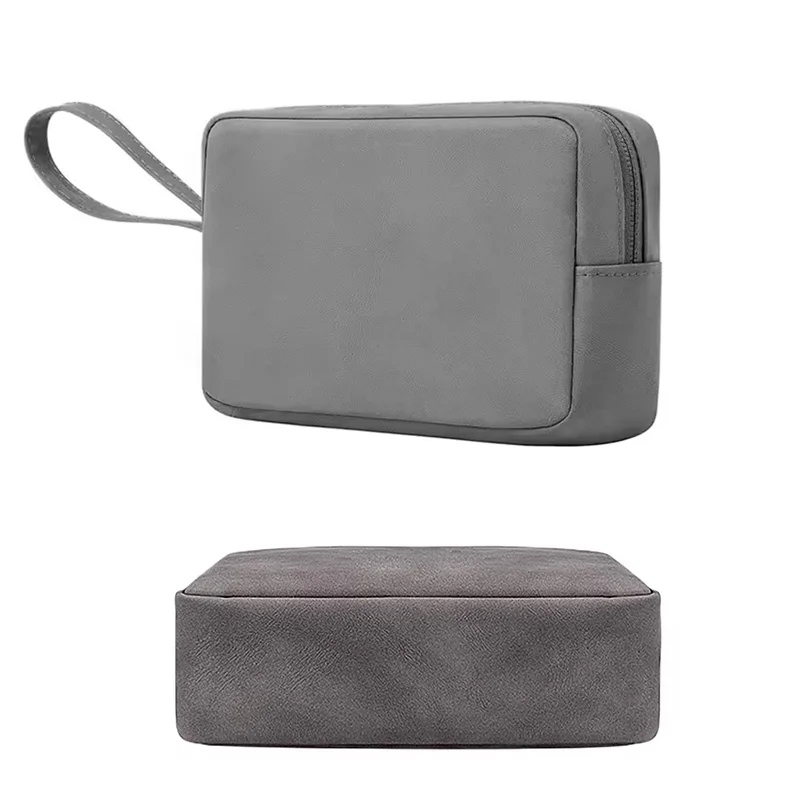 Портативная сумка для зарядных кабелей, органайзер для мелкой электроники и цифровых устройств для iPhone 16, наушников, внешнего аккумулятора, USB-кабелей и аксессуаров для зарядки.