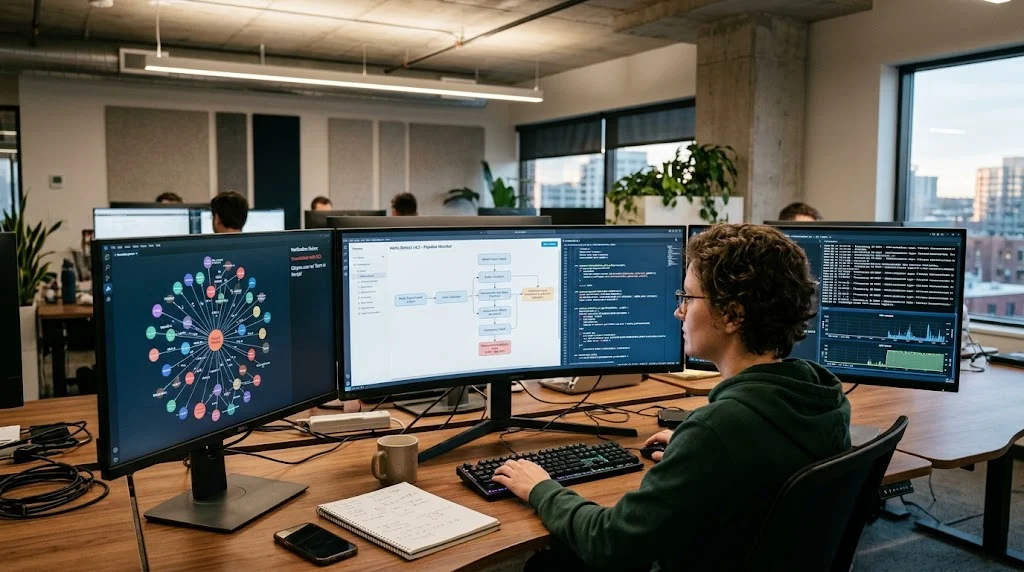
Генеративные языковые модели способны уверенно формулировать вымышленные факты, ссылаться на несурочные научные работы или ошибочно интерпретировать техническую документацию. В условиях корпоративного внедрения или автоматизации критически важных процессов такие галлюцинации превращаются в серьезный фактор риска, способный подорвать доверие пользователей к продукту.
Борьба с ложными генерациями требует комплексного подхода на уровне архитектуры системы, а не простой настройки параметров генерации. Рассмотрим, какие инженерные практики позволяют эффективно контролировать точность ответов нейросетей.
Проблематика галлюцинаций: почему модели лгут
Языковые модели работают на основе вероятностного предсказания следующего токена, опираясь на языковые паттерны, заложенные при обучении. У них нет внутреннего механизма проверки истинности утверждений в реальном мире. Если в обучающей выборке преобладали противоречивые или устаревшие данные, модель воспроизведет их с той же уверенностью, что и абсолютно точную информацию.
Попытки полностью устранить это явление исключительно за счет тонкой настройки весов или увеличения числа параметров пока не принесли универсального результата. Поэтому разработчики переносят фокус внимания на внешние контуры контроля и ограничения контекста.
Архитектурные решения для верификации
Наиболее эффективным способом снижения вероятности галлюцинаций на сегодняшний день является ограничение пространства поиска за счет внешних источников знаний и строгих алгоритмических проверок.
Использование RAG (Retrieval-Augmented Generation)
Вместо того чтобы полагаться на «память» модели, систему строят так, чтобы перед генерацией ответа она извлекала релевантные фрагменты из проверенной базы знаний или документов компании. Модель формулирует ответ строго на основе предоставленного контекста. Если нужной информации в документах нет, инструкция для промпта предписывает модели прямо заявить об этом, избегая домыслов.
Двухэтапная проверка и критика (Critic-Agent)
Усложнение пайплайна за счет разделения ролей помогает выявлять ошибки на лету. Первая модель генерирует черновой вариант ответа, а вторая специализированная модель или алгоритмический модуль проверяет утверждения на соответствие исходным данным, логическую непротиворечивость и наличие фактических несоответствий.
Практические шаги по минимизации рисков в коде
На уровне реализации пайплайна взаимодействия с LLM можно применить несколько базовых технических приемов:
- Строгая типизация и структурированный вывод: принудительный возврат данных в форматах JSON Schema через инструменты вызова функций (Function Calling) снижает риск свободного фантазирования модели.
- Понижение параметра температуры (temperature): значения близкие к нулю уменьшают вариативность генерации и заставляют модель выбирать наиболее вероятные, консервативные токены.
- Проверка цитат и ссылок: если модель ссылается на внешние источники или документы, автоматизированные скрипты должны верифицировать существование этих документов и наличие в них упомянутых тезисов.
Интеграция этих методов в продакшн позволяет перенести контроль качества ответов из плоскости случайной удачи в плоскость предсказуемых инженерных метрик.
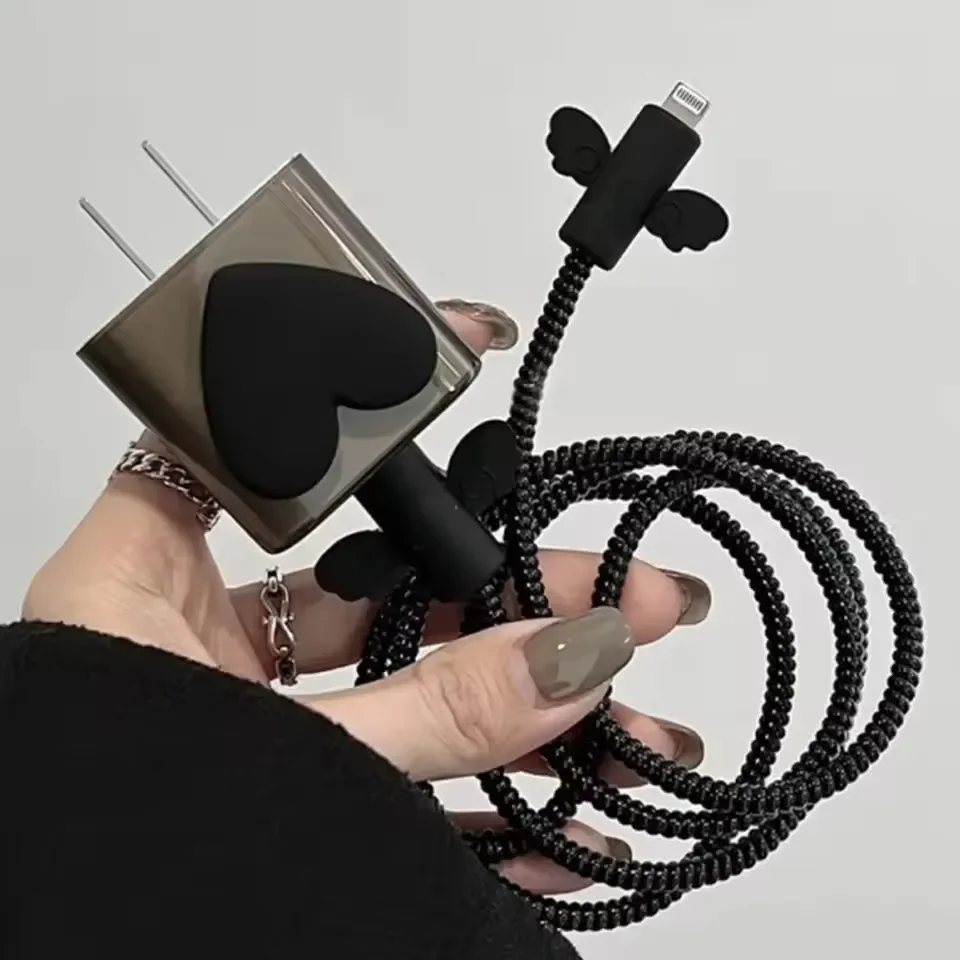 Черный набор из 5 шт. с бантиком: защитные аксессуары для кабеля зарядки и передачи данных, органайзер для зарядного устройства iPhone 18/20W, защитный чехол.
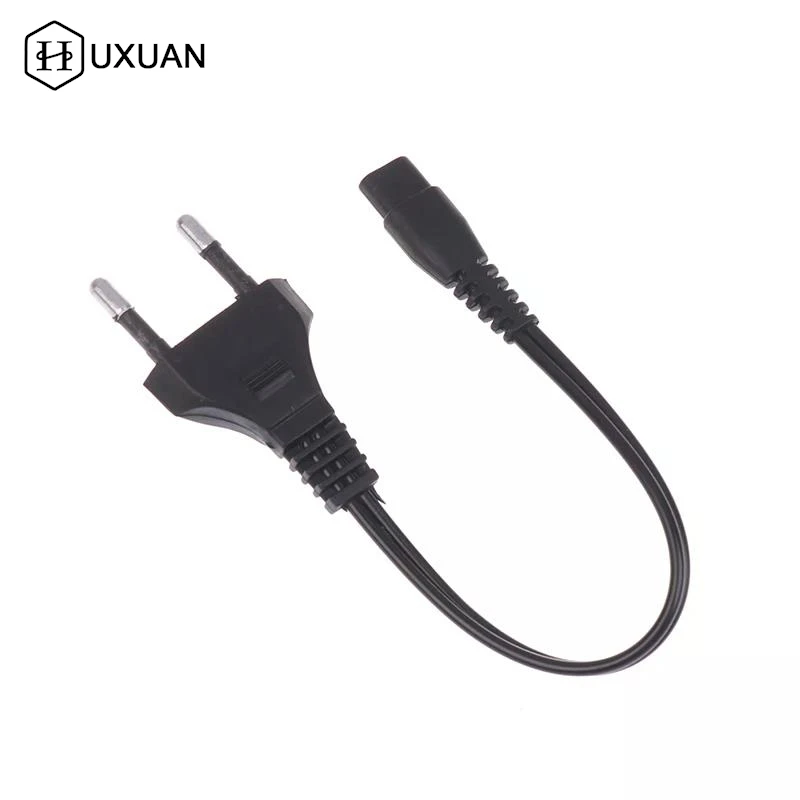 Зарядный кабель с двойным отверстием, вилка европейского стандарта, 220 В, 110 В, прямая зарядка, фонарик, зарядное устройство, шнур питания, аксессуары для фонарика
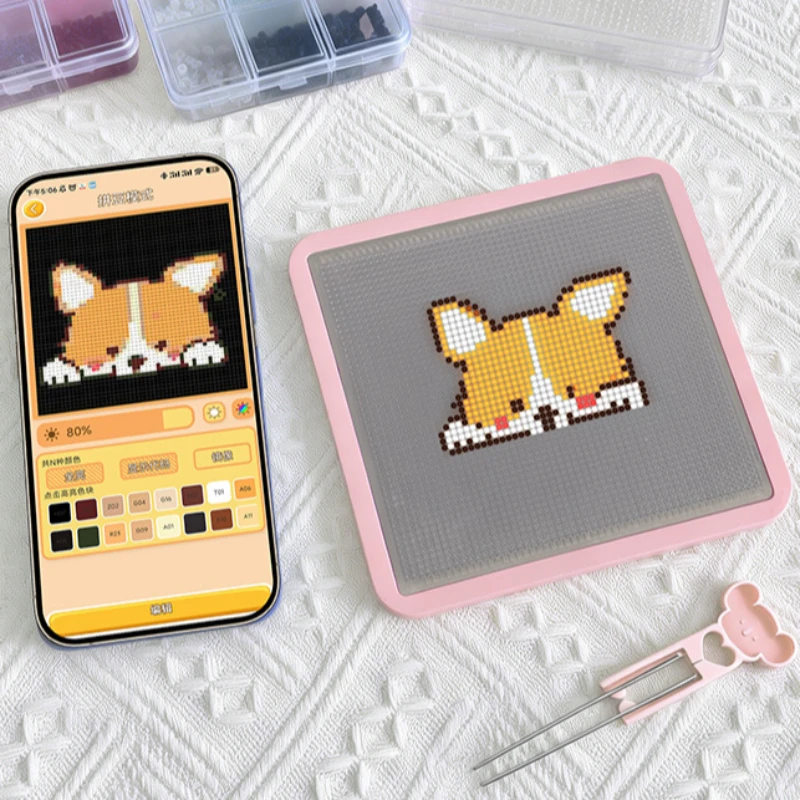 Набор для творчества с умными светодиодными плавящимися бусинами на подставке, электронные плавящиеся бусины, принадлежности для рукоделия, домашний декор ручной работы, креативный подарок на день рождения.
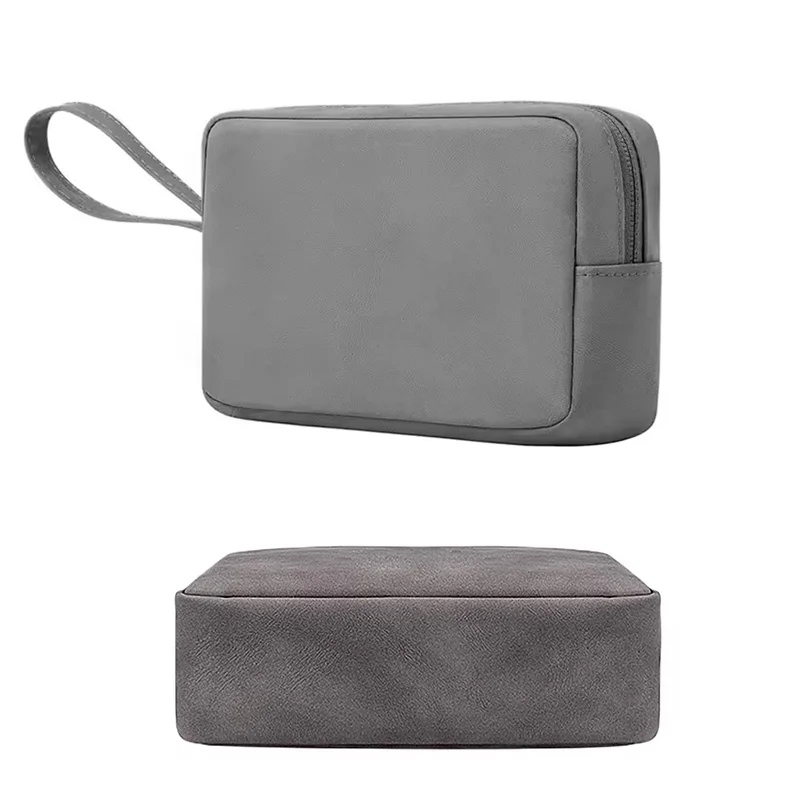 Портативная сумка для зарядных кабелей, органайзер для мелкой электроники и цифровых устройств для iPhone 16, наушников, внешнего аккумулятора, USB-кабелей и аксессуаров для зарядки.
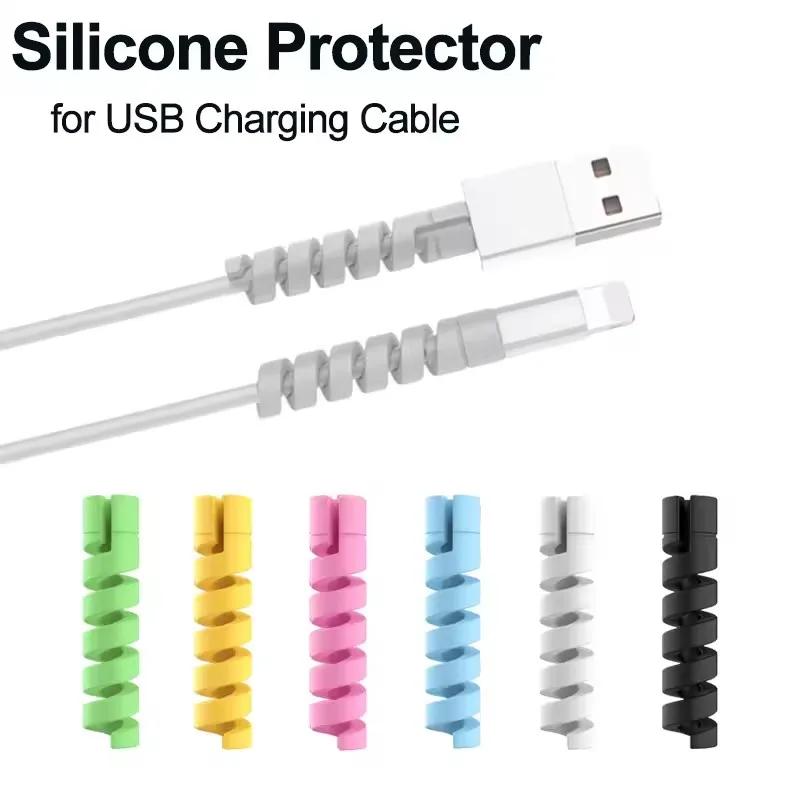 6/20 шт. силиконовых защитных чехлов для кабелей, спиральные намотчики для зарядных кабелей, защитные накладки для концов проводов, аксессуары для USB-кабелей зарядных устройств для телефонов.
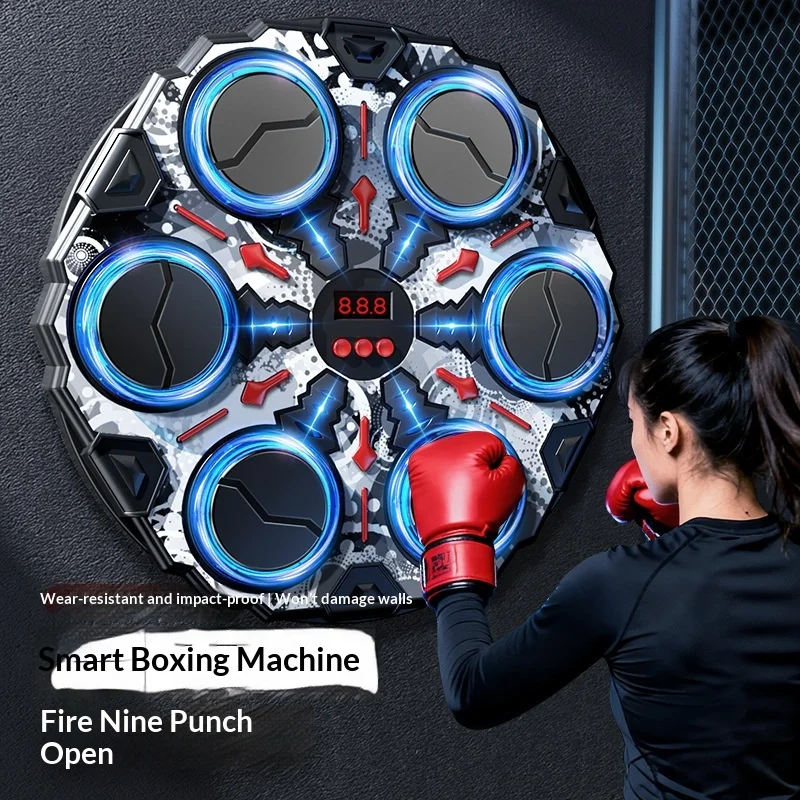 Умная музыкальная боксерская машина, настенная электронная боксерская мишень с регулируемой скоростью, тренажер для развития реакции, предназначенный для использования в помещении.