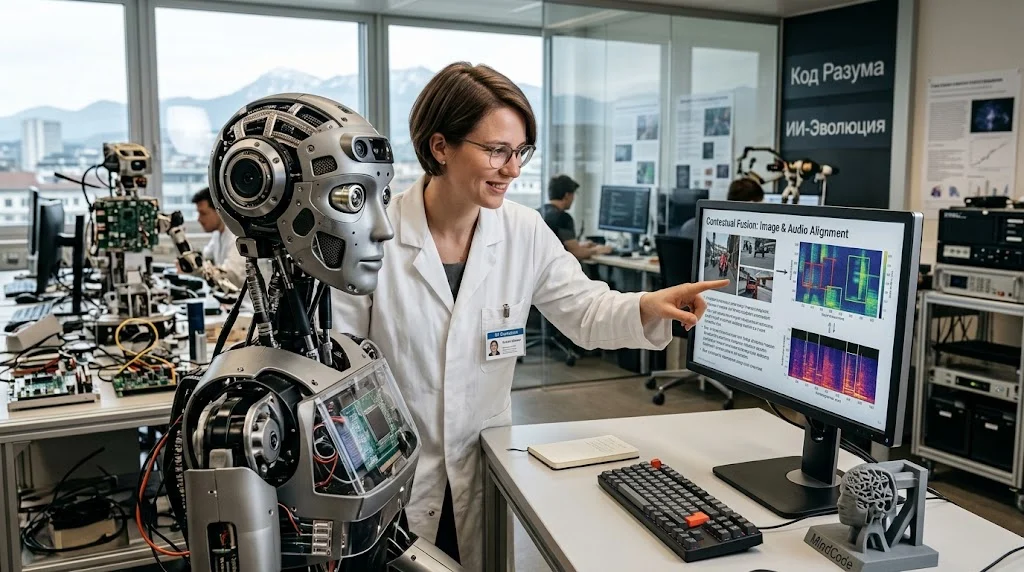
Эпоха текстовых чат-ботов постепенно уходит в прошлое. Современные системы искусственного интеллекта все меньше похожи на слепых текстовых процессоров и все больше напоминают мультимодальных агентов, способных воспринимать окружающий мир через разные каналы восприятия одновременно. Переход от узкоспециализированных модальностей к единым архитектурам изменил не только подходы к обучению нейросетей, но и саму парадигму взаимодействия человека с машиной.
Почему традиционные модели долгое время оставались ограничены одной модальностью? Исторически сложилось так, что компьютерное зрение, обработка естественного языка (NLP) и распознавание речи развивались как изолированные дисциплины. Для каждой задачи создавалась своя архитектура: сверточные сети для картинок, рекуррентные или трансформерные блоки для текста, акустические модели для звука. Попытка объединить их «на леку» с помощью конвейерных пайплайнов приводила к неизбежному накоплению ошибок и потере контекста на стыках модулей.
Переход к единому пространству признаков
Главный прорыв последних лет связан с универсальностью трансформерной архитектуры. Исследователи поняли, что различные типы данных — будь то патчи изображения, токены текста или аудиоспектрограммы — можно проецировать в единое векторное пространство с помощью соответствующих кодировщиков (encoders).
Например, визуальный энкодер разбивает изображение на мелкие фрагменты, превращая их в последовательность векторов, которые обрабатываются точно так же, как текстовые токены. Это позволяет языковой модели оперировать визуальными объектами наравне с лингвистическими конструкциями. Модель не просто «читает» описание картинки, она способна находить причинно-следственные связи между визуальным рядом и текстовым запросом.
Архитектурные подходы: ранняя и поздняя интеграция
Создание мультимодальных систем требует решения сложной инженерной задачи: как именно подружить разные типы данных внутри одной нейросети?
В ранних подходах использовалась так называемая поздняя интеграция, когда отдельные модальности обрабатывались независимыми моделями, а их результаты объединялись на финальном этапе с помощью полносвязных слоев. Такой подход страдал от сильной потери информации: тонкие нюансы изображения или интонации голоса стирались задолго до принятия финального решения.
Современные архитектуры строятся на принципе ранней и глубокой интеграции. В них единый механизм внимания (attention mechanism) пронизывает все слои сети, позволяя текстовым токенам напрямую ссылаться на пиксели изображения или фрагменты аудиодорожки. Это обеспечивает глубокий контекстуальный синтез, когда значение слова уточняется визуальным контекстом, и наоборот.
Вызовы при обучении и масштабировании
Создание мультимодальных систем сопряжено с серьезными трудностями. Во-первых, это колоссальные требования к вычислительным ресурсам. Обучение моделей, способных одновременно обрабатывать видеопоток высокого разрешения и длинные текстовые контексты, требует кластеров из тысяч специализированных ускорителей.
Во-вторых, возникает проблема выравнивания данных (alignment). Текстовые датасеты исчисляются триллионами токенов, в то время как качественно размеченные пары «изображение-текст» или «видео-аудио-текст» имеют меньший объем и часто содержат шумы. Несоответствие объемов данных приводит к тому, что языковая составляющая начинает доминировать, а визуальная или аудиальная части используются неэффективно.
Практическое применение и сдвиг парадигмы
Мультимодальность перестала быть лабораторным экспериментом и перешла в плоскость прикладных решений. Инженеры используют такие системы для анализа сложных технических чертежей, автоматической диагностики медицинских снимков в связке с историей болезни, а также для создания автономных агентов, способных ориентироваться в пространстве по видеопотоку.
Главный вывод заключается в том, что искусственный интеллект приближается к более целостному восприятию информации. Следующий этап эволюции будет определяться не столько увеличением числа параметров, сколько способностью моделей бесшовно переключаться между органами чувств, формируя глубокое и гибкое понимание реального мира.
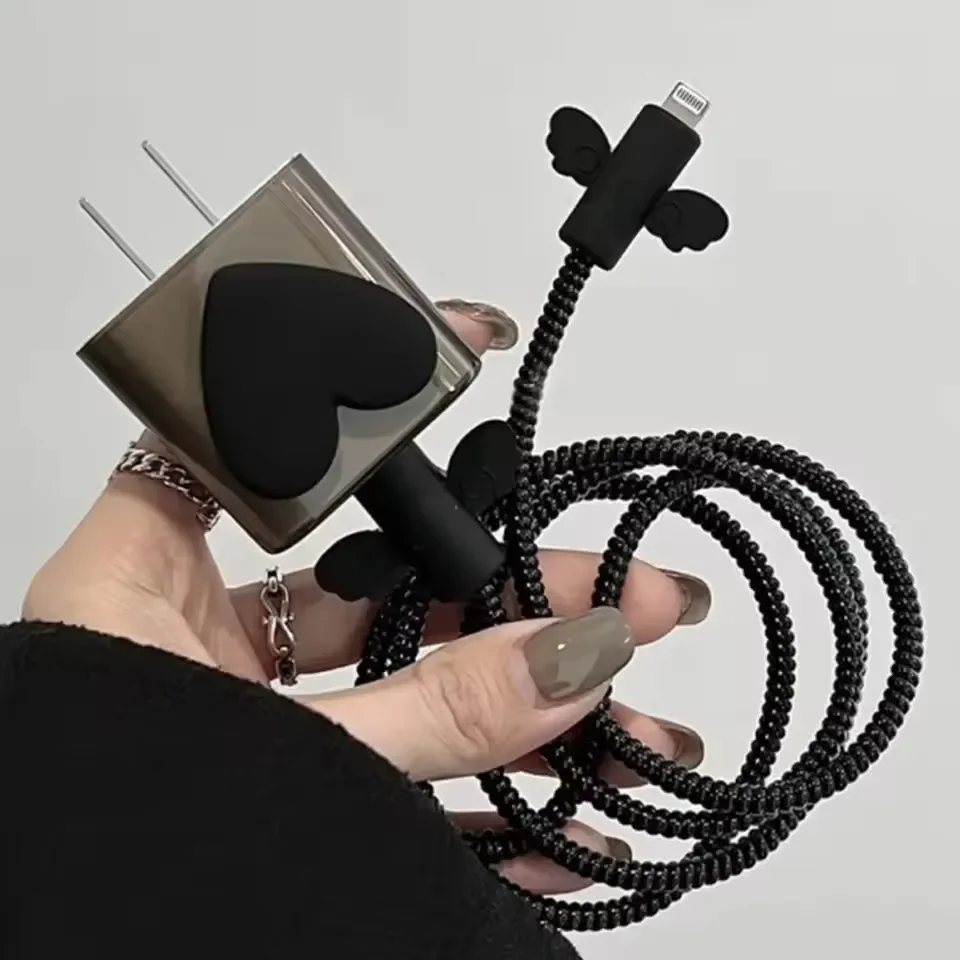 Черный набор из 5 шт. с бантиком: защитные аксессуары для кабеля зарядки и передачи данных, органайзер для зарядного устройства iPhone 18/20W, защитный чехол.
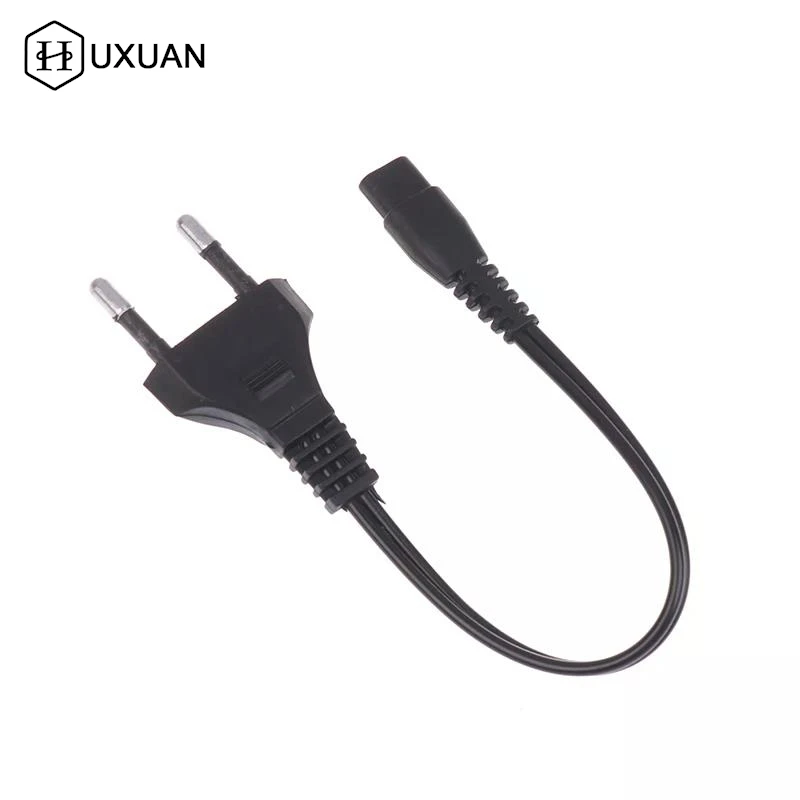 Зарядный кабель с двойным отверстием, вилка европейского стандарта, 220 В, 110 В, прямая зарядка, фонарик, зарядное устройство, шнур питания, аксессуары для фонарика
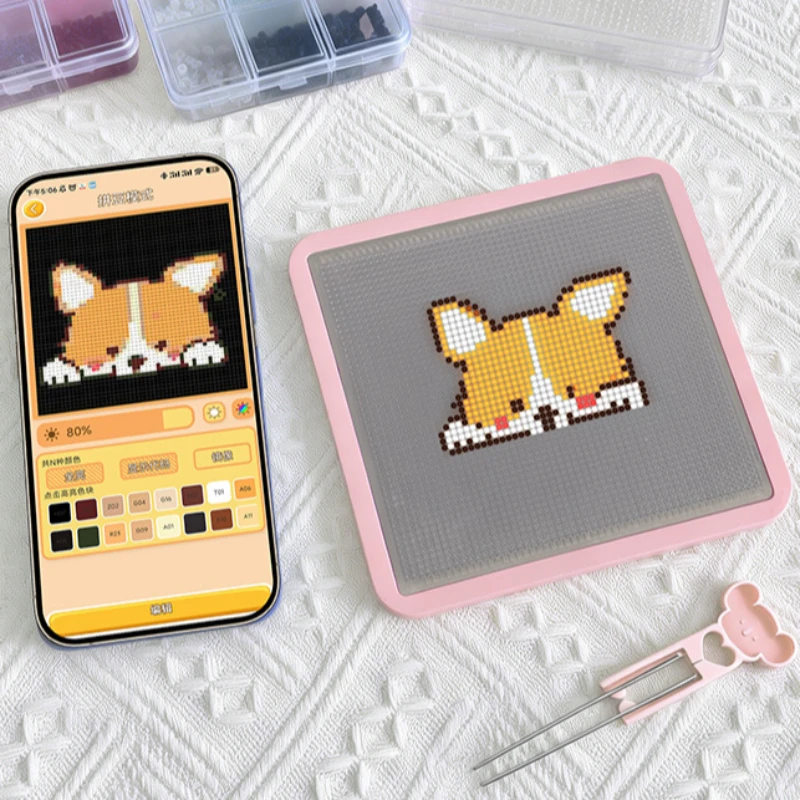 Набор для творчества с умными светодиодными плавящимися бусинами на подставке, электронные плавящиеся бусины, принадлежности для рукоделия, домашний декор ручной работы, креативный подарок на день рождения.
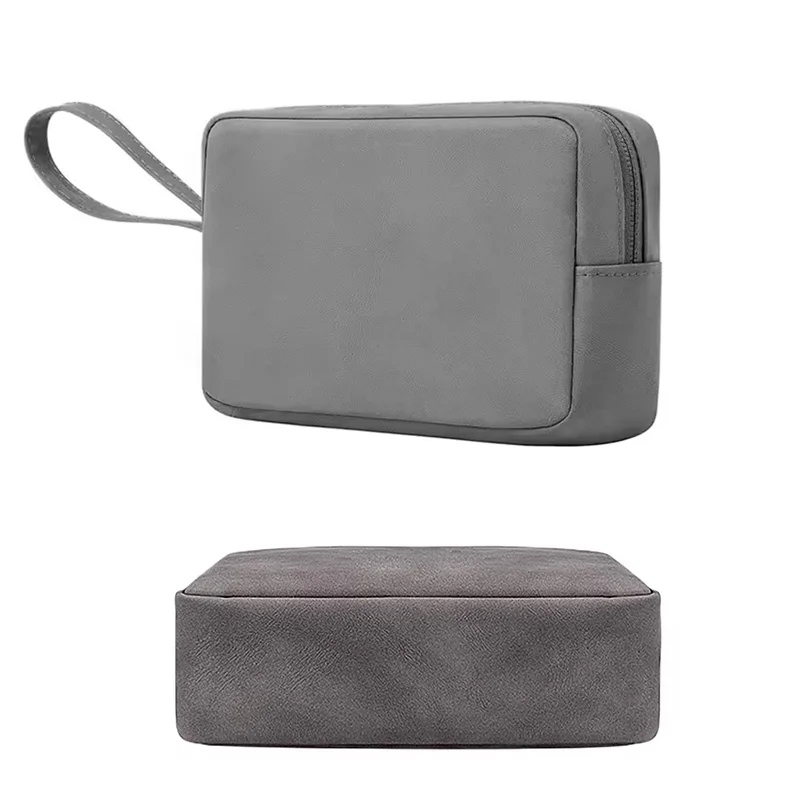 Портативная сумка для зарядных кабелей, органайзер для мелкой электроники и цифровых устройств для iPhone 16, наушников, внешнего аккумулятора, USB-кабелей и аксессуаров для зарядки.
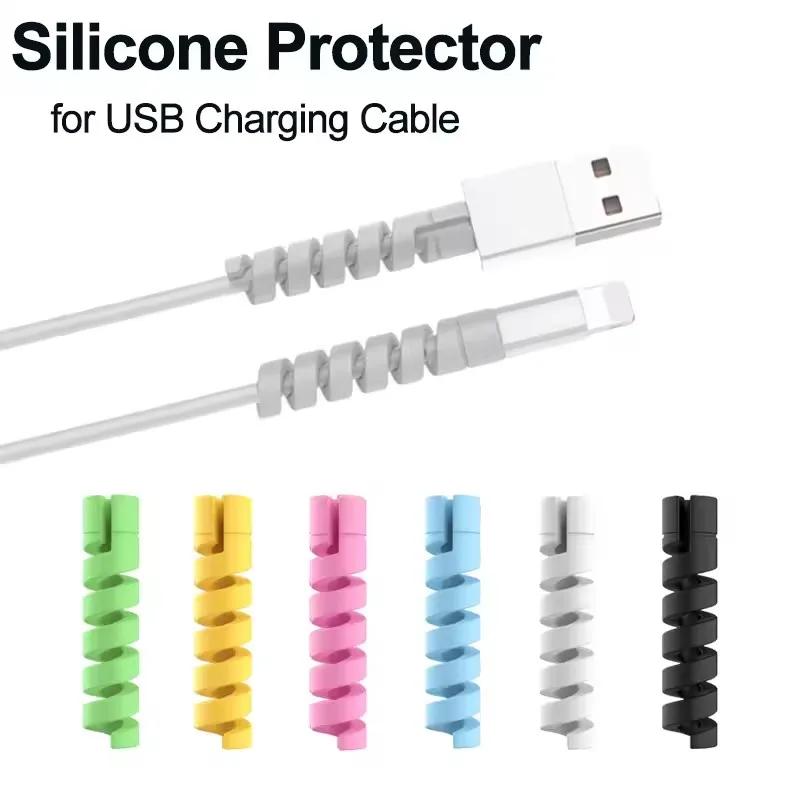 6/20 шт. силиконовых защитных чехлов для кабелей, спиральные намотчики для зарядных кабелей, защитные накладки для концов проводов, аксессуары для USB-кабелей зарядных устройств для телефонов.
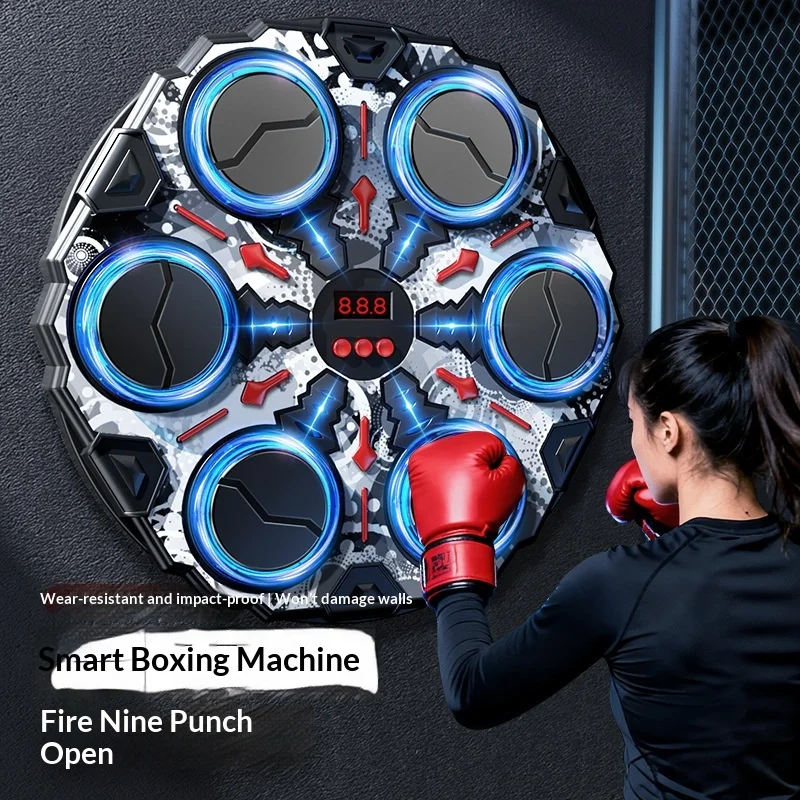 Умная музыкальная боксерская машина, настенная электронная боксерская мишень с регулируемой скоростью, тренажер для развития реакции, предназначенный для использования в помещении.